工具 · Rust · Ratatui · 2026-10-11 更新
dgxtop:設計一個不顯示假 0 的 GPU 終端監控工具
dgxtop 在終端裡監看 NVIDIA DGX Spark,或任何裝了 NVIDIA GPU 的 Linux 主機:CPU、GPU、記憶體、磁碟、網路與 GPU 程序。第二版是一次完整重寫,圍繞一條規則:讀不到的值,絕不顯示成 0。這一頁說明撐起這條規則的架構,以及每個選擇的代價。
- repository
- github.com/DennySORA/dgxtop(外部網站)
- stack
- Rust 1.92 · Ratatui · crossterm · NVML · SQLite
- platforms
- Linux x86_64/aarch64(glibc)· 已在 DGX Spark(GB10)與 RTX 5080 + RTX 3060 工作站上測試
- license
- Apache-2.0
- status
- v2 已在 main · 第一個 v2 release 尚未發佈
- updated
為什麼重寫
第一版在 UI 迴圈裡採樣硬體,驅動呼叫一慢,整個畫面就凍住。它把資料、歷史與 UI 狀態放在同一個共用結構裡,依 thermal zone 的名稱與掃描順序挑 CPU 溫度,讀不到的值直接顯示成 0。v2 規格列出十個這類問題,並為每一個給出設計上的答案:
| v1 的問題 | v2 的答案 |
|---|---|
| 只用 PID 辨識程序 | ProcessKey(主機、開機、PID namespace、PID、啟動時間)、預先持有的 pidfd 與兩階段確認 |
| 缺值變成 0 | 讀取狀態、資料種類、品質與新鮮度分成不同的軸;缺值是附原因的 null |
| 統一記憶體的語意混在一起 | 系統 RAM、GPU framebuffer 與各程序的配置分開 |
| 從使用率推估頻寬 | 量測、衍生、估算分開;沒有位元組計數器就不給吞吐量 |
| 更新間隔與累計量是假設而非量測 | 由排程器確認的有效間隔;真實經過時間與 counter 差值 |
| 歷史時窗錯位 | 帶有開機、覆蓋率與空窗資訊的時間桶 |
| 同一個 PID 在多張 GPU 上被重算 | 每個 ProcessKey 只採樣一次主機 CPU 與記憶體,再關聯到各張 GPU |
| 安裝程式不驗證下載內容 | 驗證 checksum 與壓縮檔結構,保留舊執行檔以便回滾 |
| 採樣卡住 UI | 控制、採樣與繪製分離;驅動隔離在各自的程序 |
| 建置不可重現 | 提交 Cargo.lock、固定工具鏈與 release gate |
這次重寫先寫規格再寫程式:40 項需求、15 個工作包、40 個驗收案例。之後依固定的 core 契約建成八個 crate 的 Rust workspace,約 157,000 行 Rust,附 1,373 項測試。
畫面
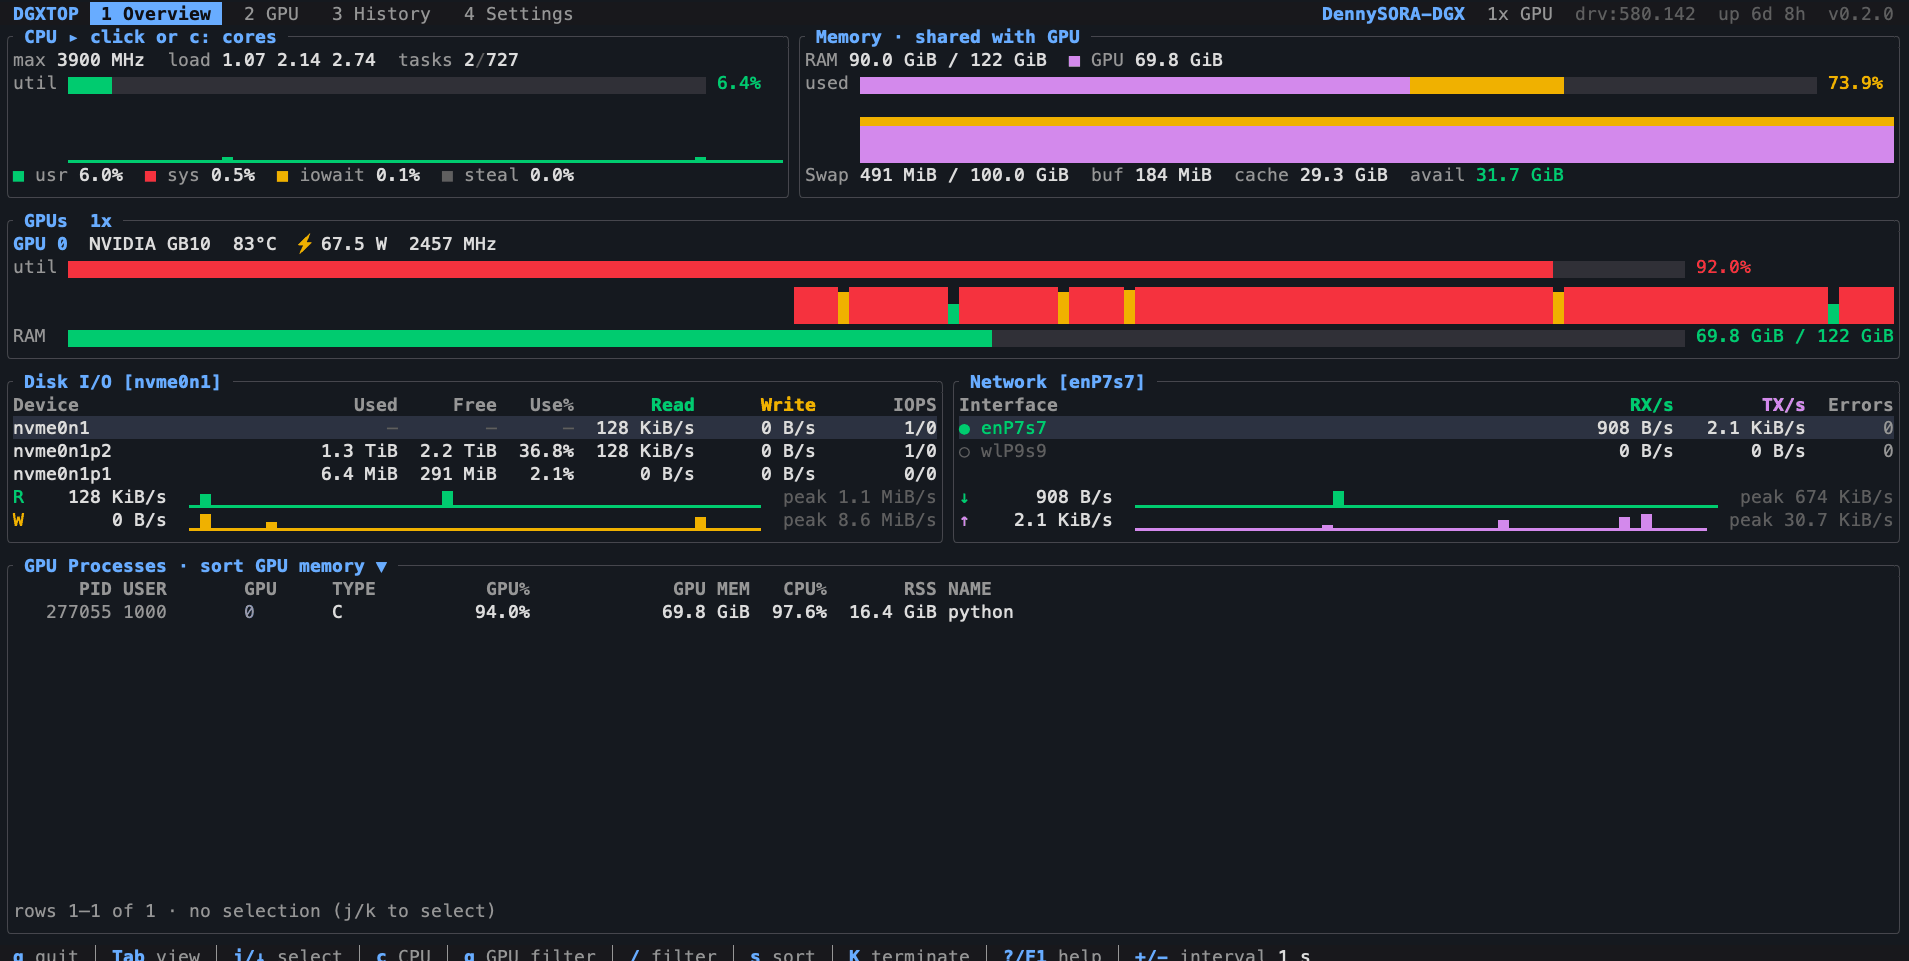
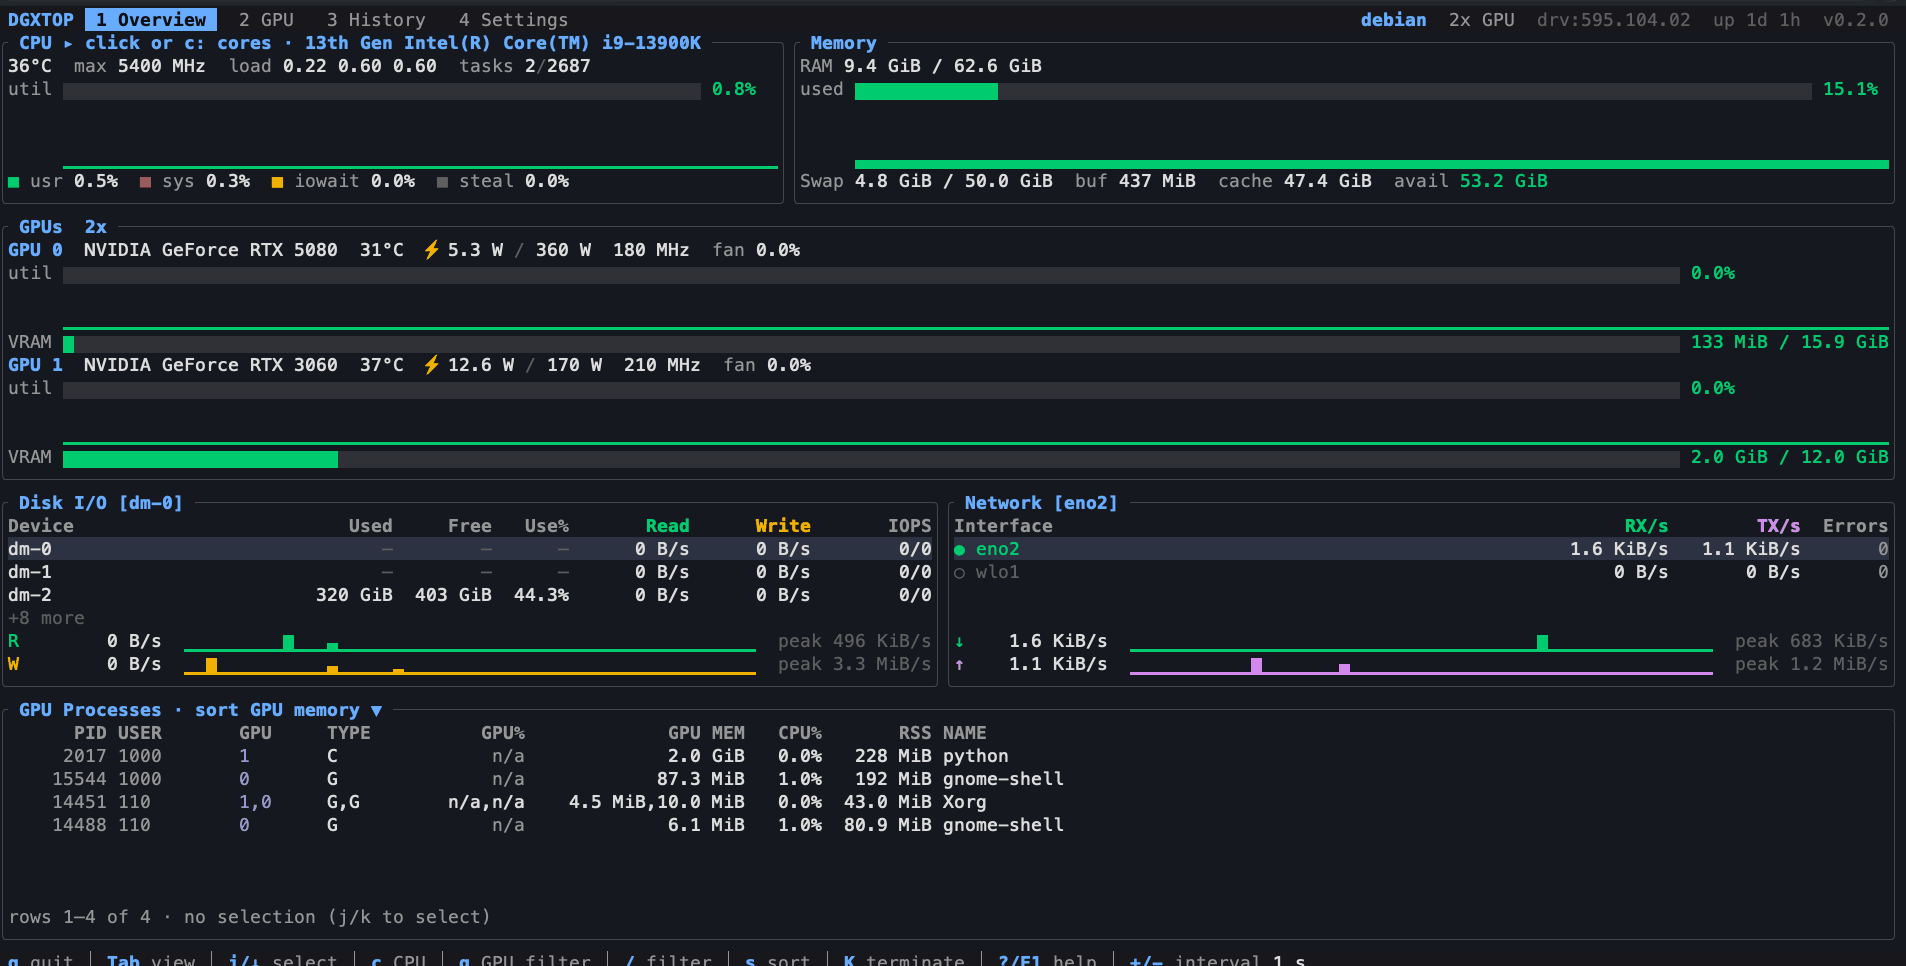
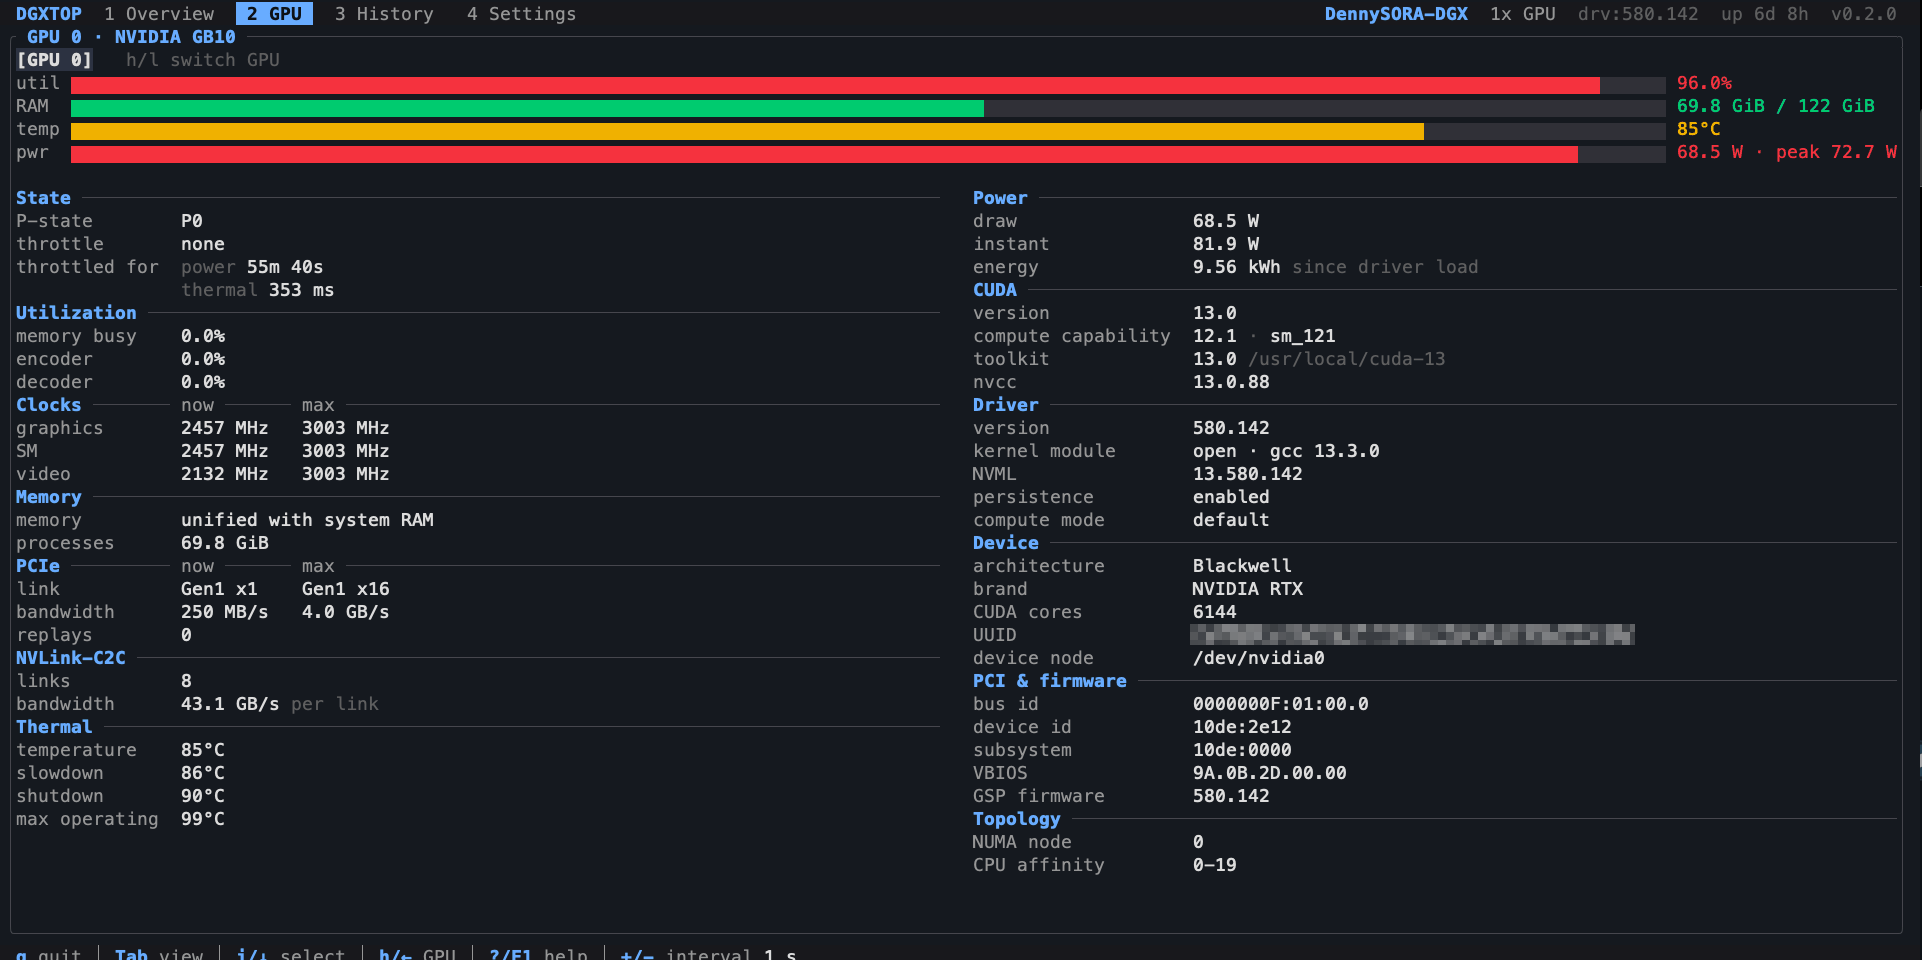
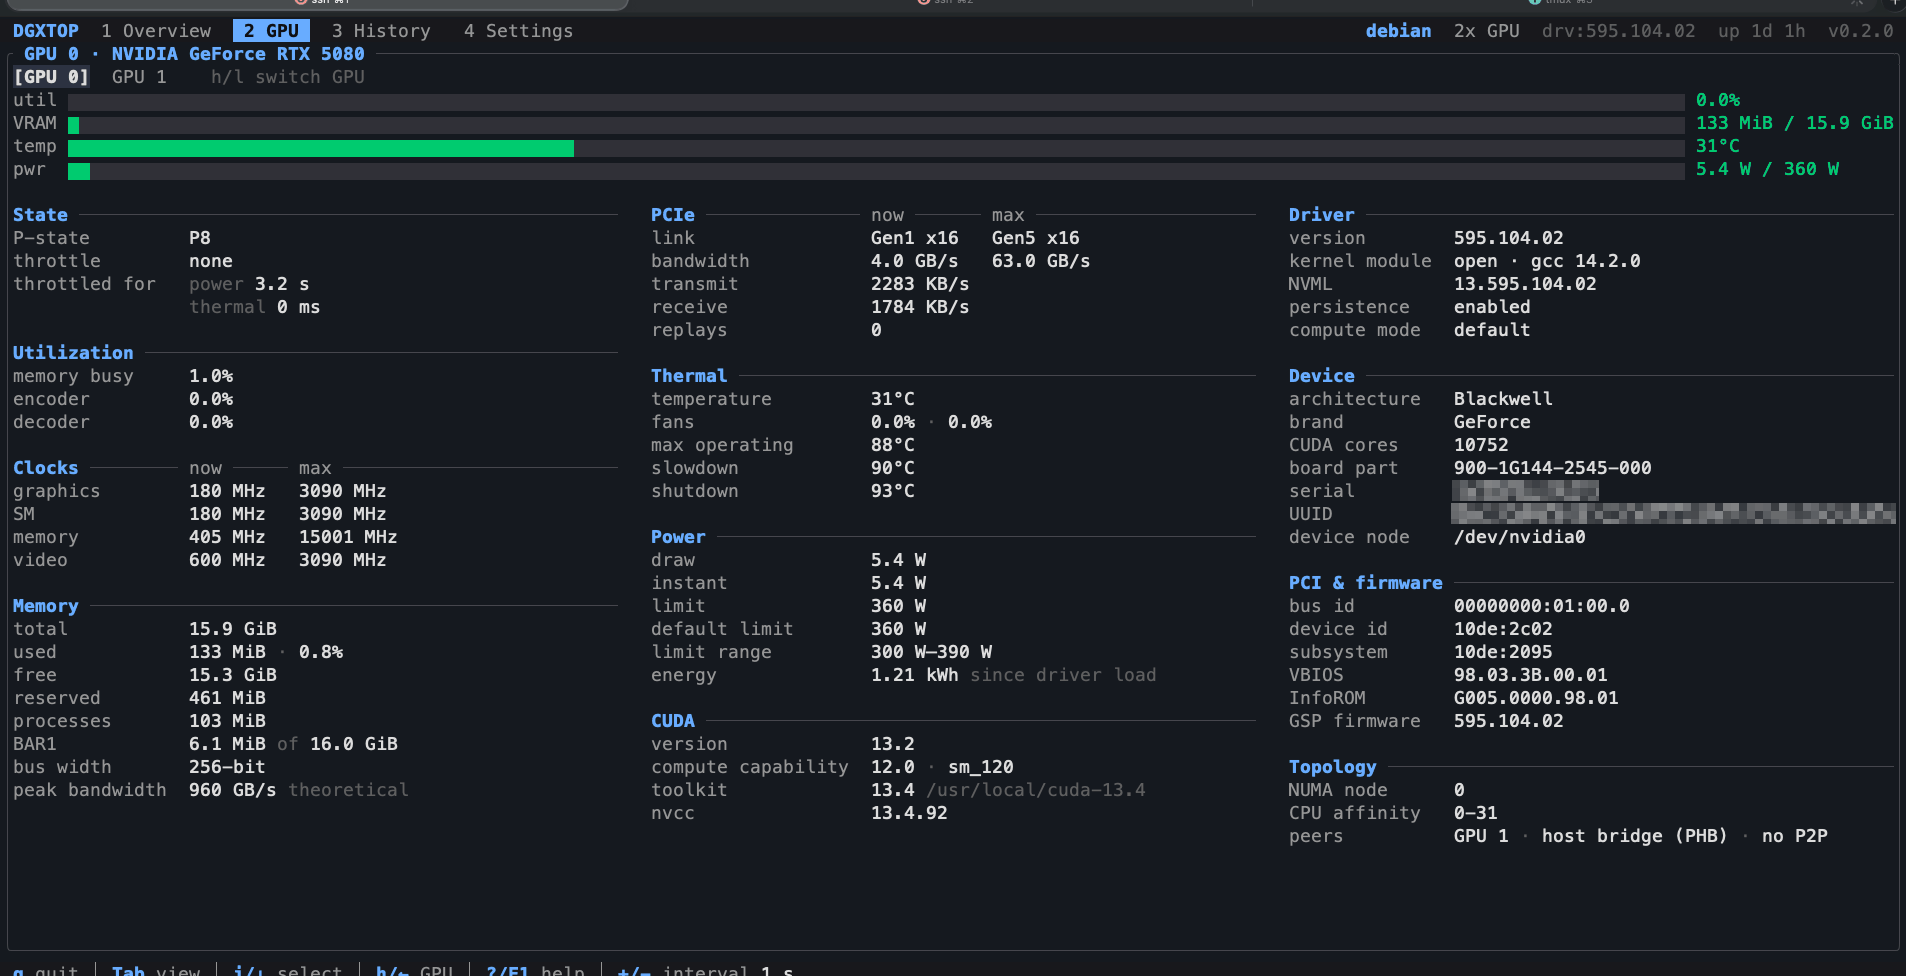
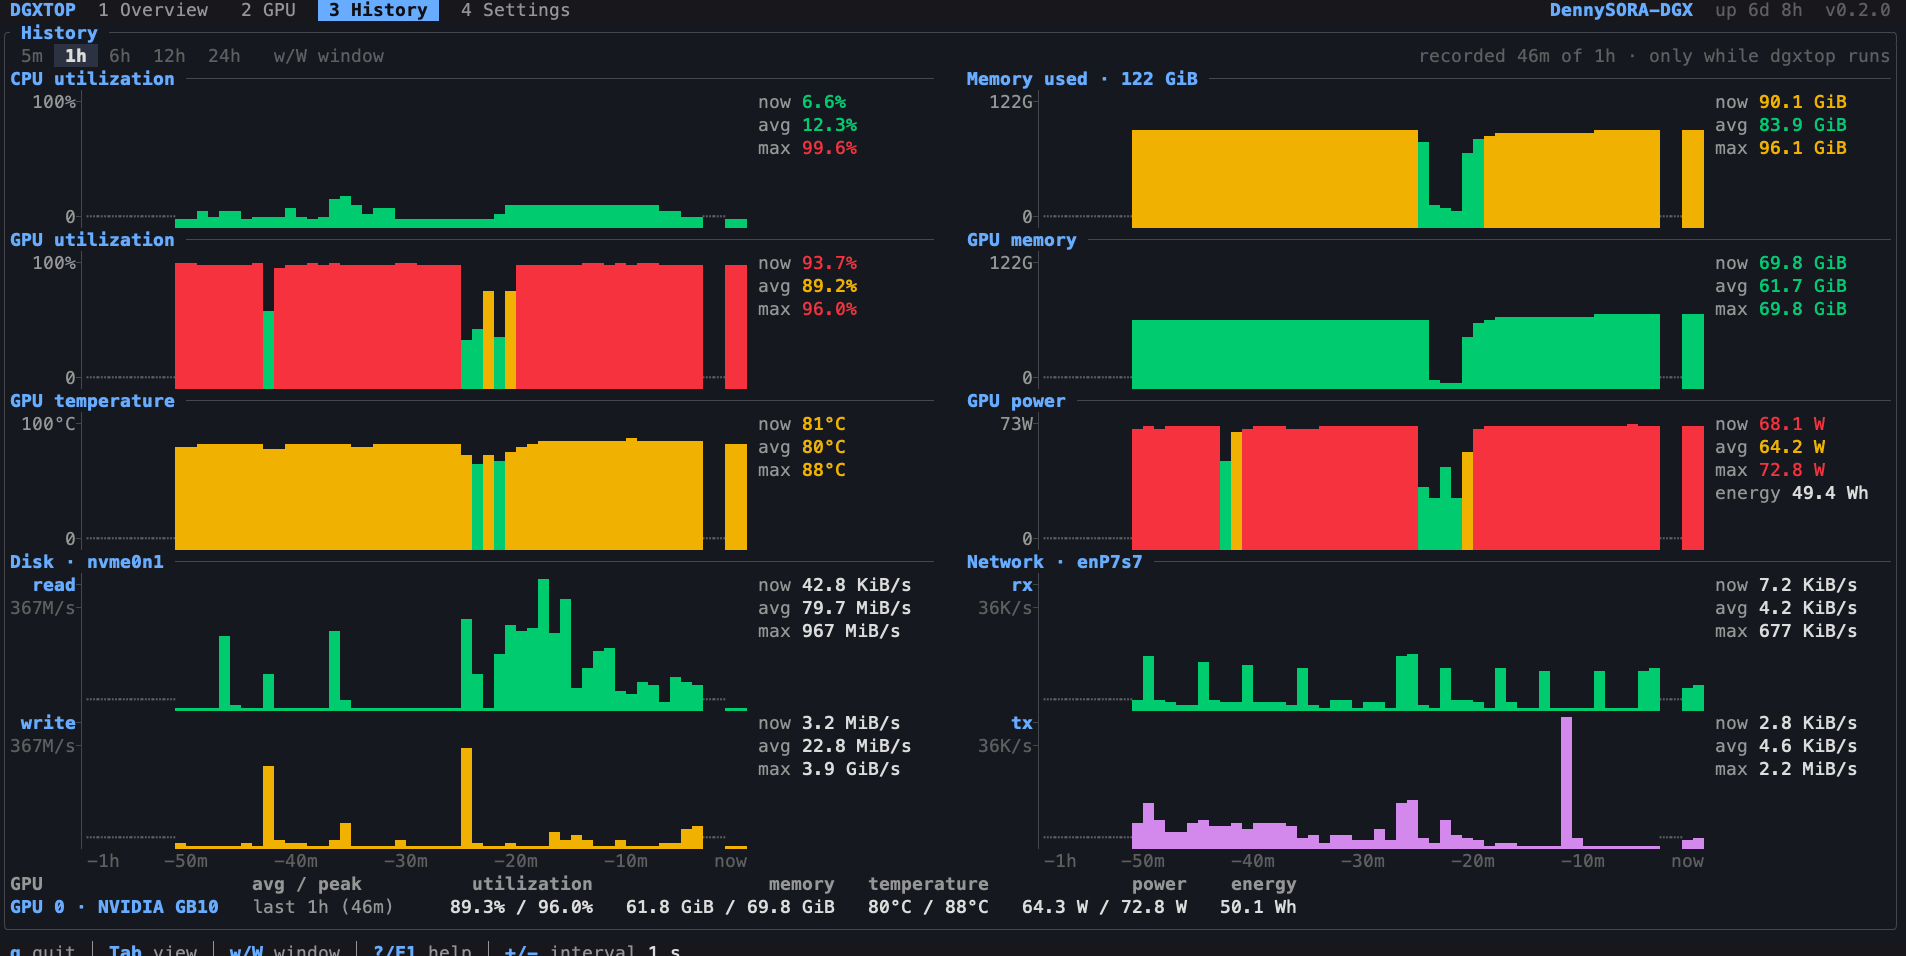
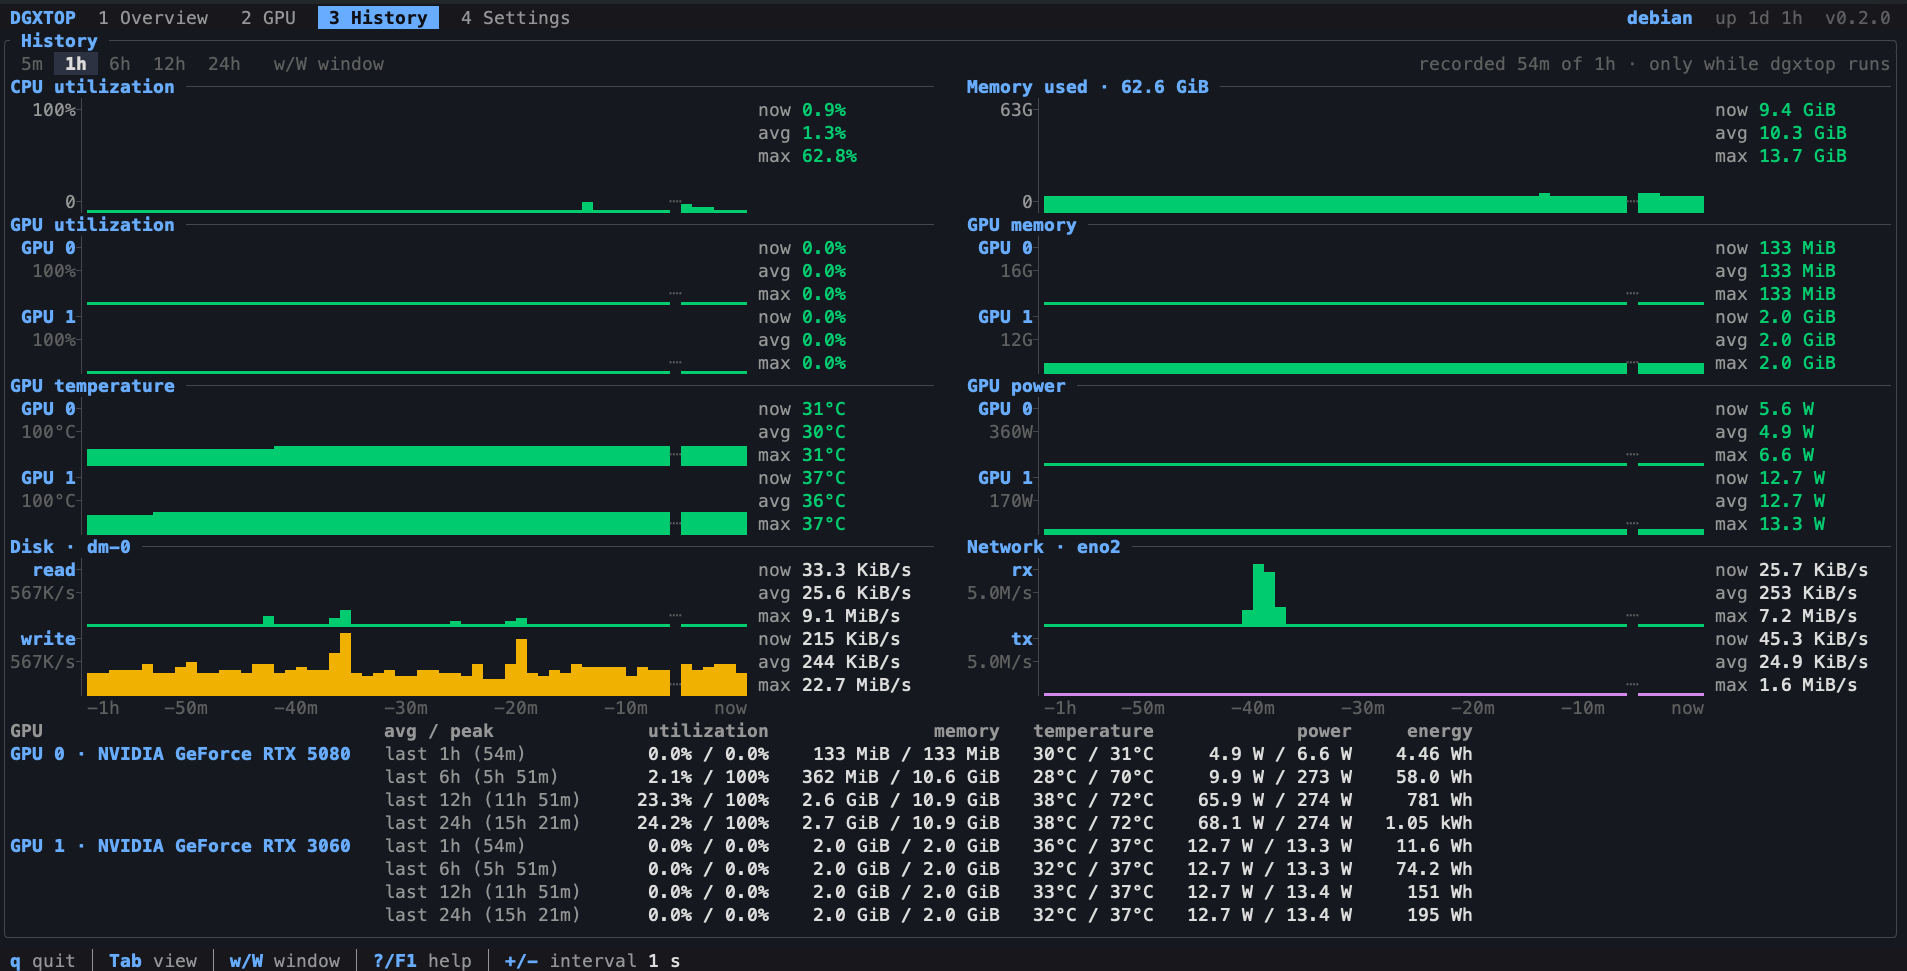
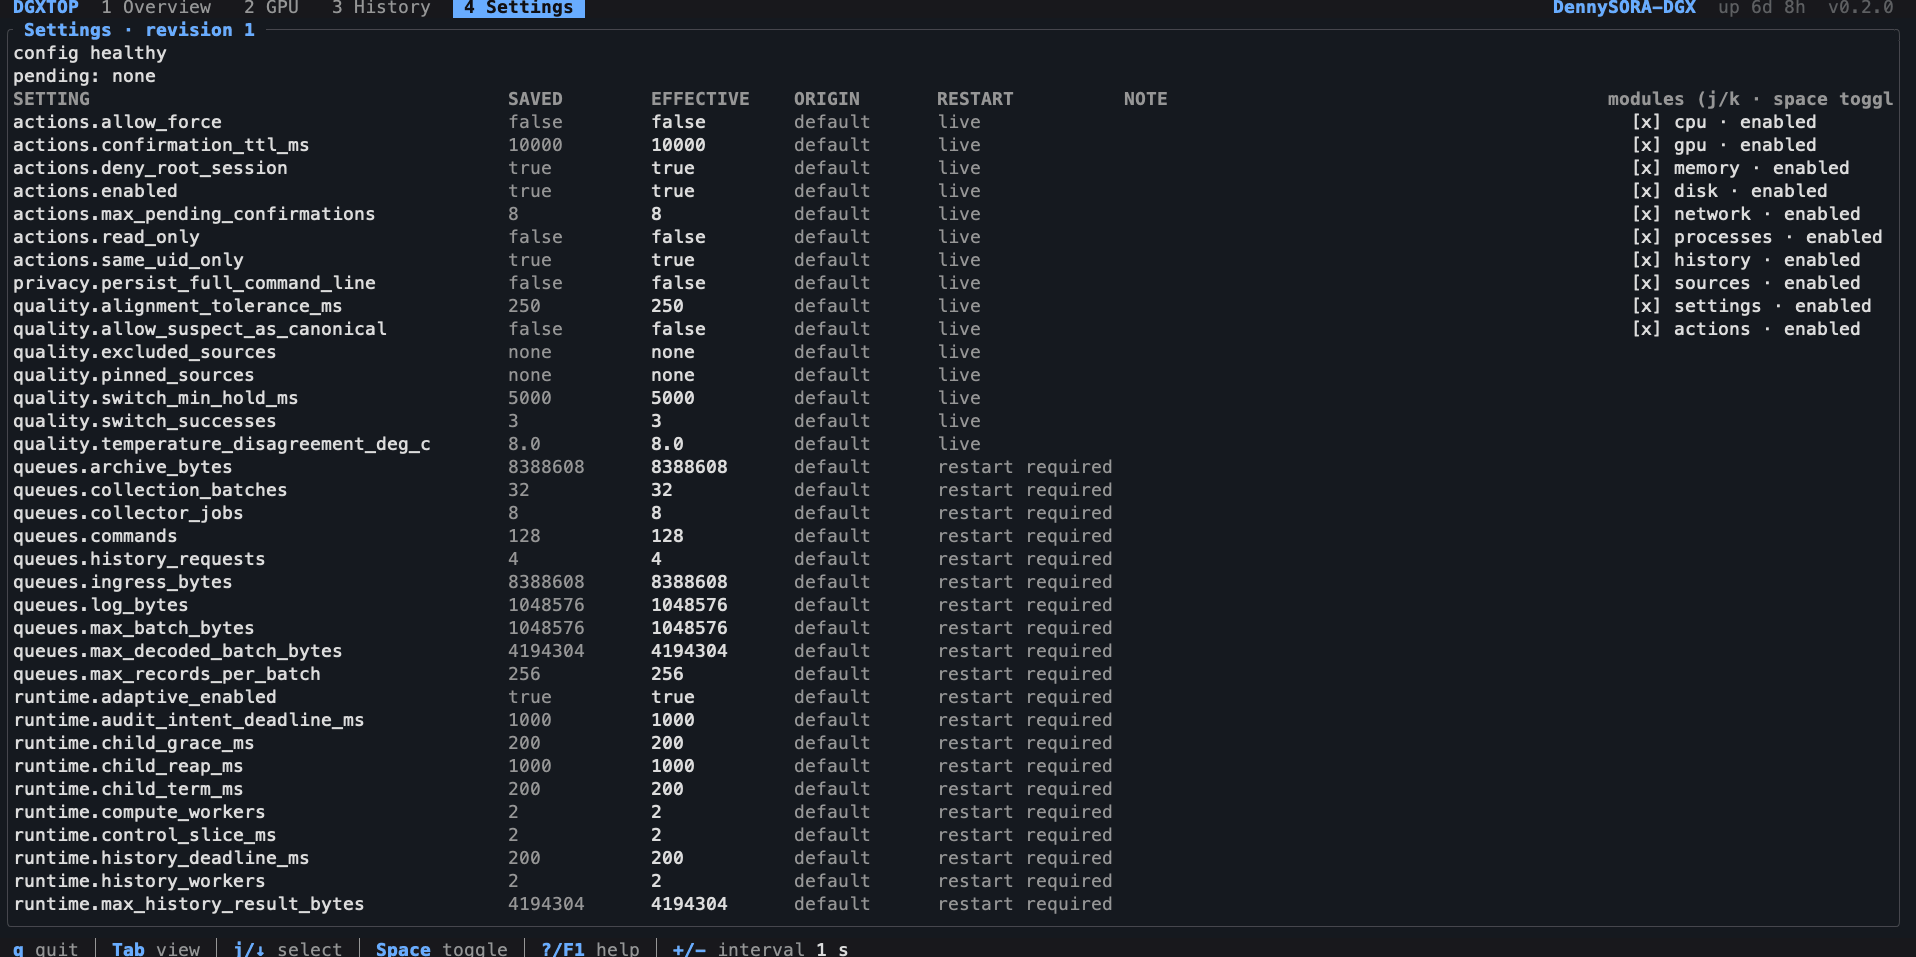
四個分頁:總覽、GPU、歷史與設定。以下截圖來自實際測試的兩台機器。
六個元件、兩條路徑
每個數值走資料路徑,每個使用者意圖走控制路徑。Manager 是唯一的寫入者:只有它持有 Store 的寫入權與程序操作的 port,所以 Viewer 與 Controller 既不能改資料,也不能送訊號。
資料路徑
- Linux + NVIDIA 驅動/proc · sysfs · NVML
- Adapter host各自一個程序
- procfs
- hwmon
- thermal
- powercap
- NVML
- network
- filesystem
- Collector正規化 · 去重 · 仲裁 · 速率
- Manager唯一的寫入者
- Store快照 · 歷史 · 設定 · 稽核
- Manager投影
- Viewer不可變 view model · Ratatui
控制路徑
- Controller按鍵 · 滑鼠 · CLI → 型別化命令
- Manager驗證 · 授權
- 設定 · 排程 · 操作 adapter訊號透過 pidfd
- 稽核 + 結果送訊號之前先落盤
- Store → Viewer顯示結果
| 元件 | 唯一的職責 | 明確禁止 |
|---|---|---|
| Adapter | 對接一種驅動或核心介面;回傳原生數值,附來源、時間與錯誤 | 自選權威數值、跨來源平均、直接寫 Store、繪製 |
| Collector | 正規化單位、去除已證明的別名、仲裁、計算速率 | 呼叫驅動內部、執行 SQL、修改設定、送訊號 |
| Manager | 排程採樣、管理政策與設定、授權命令、提交資料、產生 view model | 排版畫面,或在事件迴圈裡等待會阻塞的驅動呼叫 |
| Store | 保存快照、歷史、設定與稽核紀錄 | 自行挑選感測器、執行命令 |
| Viewer | 排版顯示模組,繪製不可變的 view model | 自行採樣、讀寫 Store、計算速率、授權任何操作 |
| Controller | 把按鍵、點擊與參數轉成帶穩定 ID 的型別化命令 | 判定來源、送訊號、繪製 |
十個顯示模組在編譯期註冊,只拿到自己的 view model 與畫面區域。某個模組 panic 時,它被隔離成模組錯誤,不會連帶拖垮採樣。
驅動卡住,只拖住一個 host
dgxtop 父程序
- 終端 · 輸入與繪製,最多 4 fps
- Manager · 每輪 2 ms 的控制迴圈
- supervisor · 管線與回收
- collector worker × 2
- hot store · 單一寫入者
- 歷史查詢 × 2
- 設定 · 稽核 · 封存 · 日誌
- 程序操作 worker
adapter host · 各自一個程序
- procfs新鮮
- hwmon新鮮
- thermal新鮮
- powercap新鮮
- NVML逾時
- network新鮮
- filesystem新鮮
↔ 匿名管線 · 長度前綴 JSON · 每個 frame ≤ 1 MiB
持續失敗的 host
- 降級
- circuit 打開
- 退避 1 s · 2 s · 4 s … 60 s
- 探測
- 暖機
回收不了 → 隔離 · 最多 8 個 host
逾時只代表結果晚到,並沒有取消那次呼叫:卡在廠商函式庫裡的執行緒無法安全地停下來。所以每個 live adapter 都在自己的常駐子程序裡執行(同一個執行檔以 adapter host 模式啟動),透過匿名管線與父程序交換附長度前綴、每個最多 1 MiB 的 JSON frame。
錯過期限的 host 會轉為降級;連續失敗 3 次後 circuit breaker 打開,重試依 1、2、4……60 秒退避。只有確實回收(reap)後才會換上新的 host;回收不了的 host 會被隔離,而且同時最多只有 8 個。
父程序只有固定數量的執行緒,不用 async runtime:這裡沒有網路 I/O,而 spawn_blocking 只會把同一個無法取消的呼叫藏到 future 後面。所有受管資料共用一份 256 MiB 預算,每條佇列除了筆數上限還有位元組上限,因為有界 channel 只數訊息,不數位元組。
可解釋的來源,不取平均
Linux 可能用好幾個介面暴露同一顆感測器,標籤也不保證它量的是什麼:temp1不一定是 CPU。dgxtop 先決定一筆讀值代表什麼(由主機、開機、實體、指標與範圍組成的 metric key),然後只比較同一個 key 的讀值。
- 建立語意對應
- 正規化單位
- 硬性驗證
- 檢查新鮮度
- 同源去重
- 排序候選
- 檢查衝突
- 遲滯 · 連勝 3 次 · 5 秒
- 提交與解釋
可能的結果
- 選中 · 68 °C · hwmon
- 來源衝突 · A 68 °C/B 42 °C
- 不支援
- 讀取失敗
- 過期
55 °C· 絕不取平均
四個獨立的軸,不壓成一個信任分數
- 讀取狀態
- 資料種類
- 品質
- 新鮮度
| 情境 | dgxtop 怎麼處理 | 畫面上看到 |
|---|---|---|
| B 是 SoC 的 zone | 不同指標,不互相比較 | CPU package 68 °C、SoC 42 °C |
| B 是 A 已證明的別名 | 同一顆感測器的兩個入口,只算一票 | 一個數值,附不一致的提示 |
| A、B 是獨立、同級且已對齊的量測 | 相差 26 °C,超過容差:衝突,數值為 null | 來源衝突與兩個讀值,絕不顯示 55 °C |
| B 回報 fault | 排除 B,選中 A | 68 °C 來自 A,並標示 B 故障 |
要切換到另一個來源,必須連續勝出 3 次且至少經過 5 秒,數值不會在感測器之間來回跳。讀取狀態、資料種類、品質與新鮮度維持四個獨立的軸,不壓成一個信任分數。
精確的歷史
速率是兩個 u64 counter 的差值,除以CLOCK_BOOTTIME上的真實經過時間;這個時鐘在休眠期間也會繼續計時。counter 歸零、重新開機或來源切換時,會開始新的區段,而不是產生負的或捏造的速率。
一分鐘的彙總無法知道區間裡的位元組是在哪一刻流動的。所以時窗總量只計入完全落在窗內的區間;跨越分鐘邊界的區間以精確的 bridge 保存、只算一次,絕不按比例拆分。
gauge 依時間加權,數值只有效到來源的過期期限為止,空窗就留著空窗。歷史存在 history.sqlite3,保留 7 天、最多 1 GiB,之前執行的紀錄也會畫出來。封存使用 synchronous=NORMAL,操作稽核使用 FULL:圖表少了最後一秒可以接受,訊號的紀錄不見則不行。
受保護的程序終止
- K選取一個 GPU 程序
- 準備同使用者 · 非 root · 不是 PID 1、dgxtop 或其 host
- pidfd_open核對 /proc 身分
- 確認10 秒一次性 token · y
- 稽核 intentSQLite synchronous=FULL
- pidfd_send_signalSIGTERM
已送出訊號
- 已觀察到結束
- 仍在執行
intent 之後崩潰 → 未知,絕不重送
SIGKILL 預設關閉(allow_force)
終止錯的程序,是監控工具最糟的失誤。所以終止是兩階段、有稽核的操作,對象是 ProcessKey(主機、開機、PID namespace、PID 與啟動時間),絕不是列號或單獨的 PID。
準備階段檢查使用者,拒絕 root 會話、PID 1、dgxtop 本身與它自己的 host,開啟 pidfd 後再透過 /proc重新核對身分。確認用的是 10 秒內有效的一次性 token。送訊號之前先以 synchronous=FULL寫入 intent,訊號再透過準備時就持有的 pidfd 送出,所以重用的 PID 不會被誤擊。
結果會分開標示已送出訊號與已觀察到結束。如果在 intent 落盤後、結果寫入前崩潰,該操作記為未知且絕不重送:資料庫 commit 與系統呼叫沒有共同的交易,所以誠實的保證是「至多一次」。SIGKILL 預設關閉,除非設定 actions.allow_force;--read-only 會關閉所有操作。
資源預算與過載
dgxtop 管理的每一筆配置都從同一本 256 MiB 的帳目扣除,並依用途分區。這些是准入上限,不是量到的記憶體:配置器開銷、執行緒堆疊與 NVIDIA 函式庫都另外計算,所以規格另外為整個程序樹訂了 384 MiB 的目標。
| 分區 | MiB | 內容 |
|---|---|---|
| 目錄與 metadata | 24 | 名稱、tombstone、仲裁前態 |
| 原始候選 | 32 | 供來源診斷的 60 秒證據 |
| 即時狀態 | 16 | 512 條序列、256 個程序、1,024 個 GPU 關聯 |
| 原解析歷史 | 32 | 最近 300 秒 |
| 分鐘彙總 | 96 | 24 小時的彙總、來源切換與空窗 |
| 輸入(ingress) | 8 | 所有存活的 IPC 與解碼 buffer |
| 呈現 | 12 | view model 與格式化快取 |
| 歷史查詢 | 16 | 執行中查詢釘住的快照 |
| 控制與保留 | 20 | 命令、封存 journal、日誌、安全保留 |
- 正常完整速率
- 壓力停可選工作 · 2 fps
- 節流限制查詢 · 拉長週期
- 恢復中每 30 秒退一級
負載過高時,dgxtop 會看得見地降級,而不是默默失真。壓力狀態先停掉可選工作、繪製降到最多 2 fps;節流狀態限制查詢並拉長採樣週期,橫幅會同時顯示設定值與實際值。恢復時每 30 秒健康才退一級,遺失的採樣絕不補值。
邊界與驗證
- dgxtop-runtimehost · IPC · worker→ 只依賴 dgxtop-core
- dgxtop-adaptersprocfs · NVML · pidfd→ 只依賴 dgxtop-core
- dgxtop-collectors仲裁 · 速率→ 只依賴 dgxtop-core
- dgxtop-store歷史 · SQLite→ 只依賴 dgxtop-core
- dgxtop-manager用例 · 會話→ 只依賴 dgxtop-core
- dgxtop-uiRatatui · keymap→ 只依賴 dgxtop-core
CI 檢查 · check_boundaries.py
workspace 有八個 crate。每個實作 crate 只依賴 dgxtop-core,只有組裝根看得到全部;CI 腳本讀取 cargo metadata,任何 crate 依賴另一個實作 crate 就讓建置失敗。core 本身從不依賴 NVML、libc、SQLite 或 UI。
格式、lint、1,373 項測試(aarch64 上 1,372 項)、依賴邊界與真實硬體測試,在裝有 RTX 5080 與 RTX 3060 的 Debian 13 工作站和 DGX Spark 上都通過。驗收報告追蹤 40 個案例:12 個通過、24 個尚未執行(多半是需要另外啟動的端對端測試),4 個卡在正式 release、3 次 30 分鐘的效能基準與 72 小時 soak。在這些完成之前,沒有任何平台被宣稱為已驗收,效能數字也仍只是目標。
取捨
- 每個 adapter 一個程序,而不是一條執行緒。多付常駐記憶體與 IPC 的成本,換來卡住的驅動無法凍結其他任何東西。
- 固定的執行緒與 crossbeam channel,而不是 async runtime。沒有網路 I/O 值得引入它。
- 編譯期註冊,而不是外掛。adapter 與顯示模組不需要不穩定的 Rust ABI,也不增加攻擊面。
- 顯示衝突,而不是取平均。畫面沒那麼整齊,但絕不出現沒有任何感測器回報過的數字。
- 至多一次訊號,而不是重試。結果未知,就顯示未知。
- 只在變化時重繪,最多 4 fps。監控不需要 60 fps,而且慢的終端絕不能卡住輸入。