工程思考 · 研究筆記
我想做的 VPN Manager:讓不同 App 各走自己的 VPN
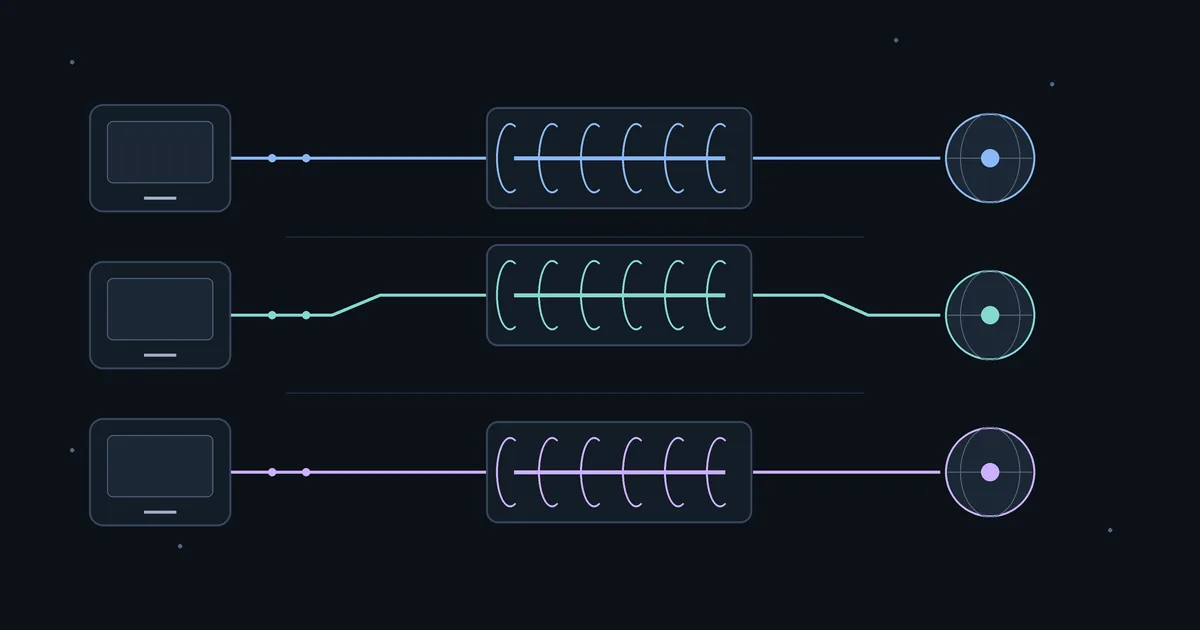
我想開發 VPN Manager:為不同 App 與 Service 規劃獨立 VPN Instance、Linux 原生隔離、故障封閉、Provider 自舉,以及流量監控。
本文目錄
VPN MANAGER / 開發筆記
最初想做什麼
主機原本的網路不變。
指定的 App 只走指定出口。
最初會想做 VPN Manager,其實就是覺得一般 VPN
客戶端大多偏向整台電腦一起切換。
但我需要的不是這個。
我想指定哪些
App 走哪條 VPN,沒被管理的程式就繼續使用主機原本的網路。
例如我同時開著瀏覽器、下載程式,以及其他 App。
瀏覽器交給
Instance A,下載程式交給
Instance B,其他則使用原本的網路。
A 和 B 各自有自己的
WireGuard identity、DNS、Gateway、連線資源和生命週期。
如果 A 斷線,我寧願瀏覽器直接斷網。
它不能自動跑去 B,更不能退回 ISP
原本的出口。
如果 A 斷線:瀏覽器就沒有網路。
Instance B
和沒被管理的程式照常運作,不需要跟著切換。
我還希望可以把不同 VPN 供應商的帳號、Profile 和 Gateway
放在同一套系統裡管理。
指定的 App 或 Service 最好能直接從 OS
的網路層隔離,不用 Docker,也不用修改整台電腦的 default route。
流量資訊也是我想做的功能。
我想看每個 Instance 用了多少流量、哪些
Gateway 正在塞車、DNS 花了多久,還有哪個程序吃掉最多 CPU 或記憶體。
如果只有一個
Connected,我覺得意義不大。
類似的做法其實已經有人做了,也有不少人自己用 netns、Proxy 和 firewall
拼出需要的環境。
但我想把多條 VPN 的管理、App
隔離、故障恢復和監控放在一起,不用每次都自己接一堆東西。
先從整個系統架構開始。
目前的操作畫面


01整個系統的主幹
整體控制路徑先這樣規劃:
React UI→VPN Web API / VPN Core→Instance Manager→Instance Controller
這裡我把 Instance Manager 做成獨立程序。
所有
Instance 的啟動、停止、generation、資源租約和恢復都交給它。
Controller
只接收 UI/API 的操作意圖,不去轉送 App 的 TCP/UDP 資料。
要動到 OS 權限的部分就交給
Platform Manager。
不管是 network
namespace、process sandbox、FD、firewall policy,還是 macOS 的
capture/deny,都由它負責。
我不希望其他元件因為方便,就直接跑去改系統網路設定。
Store 負責把狀態存下來,Metrics 收集數據,Performance Manager
再處理分析與授權的測試。
這些東西不要卡在 App 的封包路徑上。
例如
Metrics
或資料庫寫入變慢,不能因此讓正在傳送的封包排隊;新的狀態變更則照原本的封閉規則處理。
| 執行邊界 | 主要責任 |
|---|---|
vpn-controllerd |
提供 React 靜態資產、VPN Web API、VPN Core,以及 Provider/Security/Metrics/Performance 控制協調。 |
vpn-instance-managerd |
跨 Instance 唯一生命週期 owner;管理 desired state、generation、identity/resource lease、外層 Watchdog 與復原對帳。 |
vpn-platformd |
獨占高權限 OS 操作;執行 Linux/macOS Adapter、sandbox、FD/policy 建立、spawn、seal 與安全證據蒐集。 |
vpn-stored |
唯一 SQLite owner;管理
control.sqlite、metrics.sqlite、secret、revision、operation
journal 與備份。
|
vpn-instance × N |
每條 VPN 的獨立 worker;擁有自己的 GotaTun、DNS、Gateway、Port、Metrics 與內層 Watchdog。 |
vpn-provider-worker |
按 Provider job 執行 API 操作、route-bound IP preflight 與受限 connector,不自行建立或啟停 Instance。 |
| macOS system extension(若啟用) | 處理受管 App 的 flow capture、deny 與 bridge;依原生平台能力提供安全邊界。 |
完整的元件歸屬
元件我先依照誰負責管理、誰有權限操作來分類。
光是畫一堆方塊沒什麼用,重要的是某個程序掛了,會影響到誰,以及誰可以把它重新啟動。
02VPN Instance 架構
每條 Instance 都有自己的 GotaTun、DNS Controller、Port
Controller、Gateway Manager、Metrics 和 Watchdog。
WireGuard
identity、DNS cache、socket、buffer、queue 也都要分開。
CPU、NIC 和
OS 可以共用,但 A 的執行狀態不應該和 B 混在一起。
有個地方要先講清楚。
GotaTun 是 WireGuard 引擎,本身不是完整的 TCP/IP socket
stack。
所以接上 GotaTun,不代表 TCP/UDP
連線處理就全部有了,這部分還是得另外處理。
Linux 我傾向直接用隔離 network namespace 裡的 kernel TCP/IP stack。
macOS
的顯式 Proxy 則由每條 Instance 自己使用 smoltcp 加上
GotaTun。
各自的 socket、buffer、queue 也要獨立,不要讓 Controller
的 SQL 或 Provider HTTP 呼叫卡到真正的網路流量。
DNS 也要跟著 Instance 走。
解析失敗就回報失敗,不能偷偷改問 host
resolver。
Gateway 收到 HTTP CONNECT 或 SOCKS5 TCP/UDP
後,要真的交給自己的 Instance 建立目的地連線。
Port Forward
只能轉到同一個 Instance 裡已驗證的 App endpoint,不能為了省事直接接到
host 的 127.0.0.1。
受管 App、Gateway 和 Port Forward 的差別
我把流量入口分成三種。
受管 App
要先進入隔離環境,它自己不能選 host 網路。
Gateway
只負責明確交給 HTTP/SOCKS Proxy 的流量,App
另外建立的連線不會自動受到保護。
Port Forward
則是從 VPN 進來的流量,只能送到同一個 Instance 裡有有效
AppEndpointLease 的 App。
DNS 和 IPv6 也不能有特例。
如果 Instance 的 DNS
路徑不可用,那就不查。
IPv6 如果沒有能驗證的 tunnel
路徑,也不能自動放它走主機網路。
macOS 的 App 隔離比較麻煩
macOS 這邊其實比較麻煩。
顯式 Proxy 可以做,但它只管真正交給 Proxy
的流量。
像 QUIC、WebRTC,或 App 自己使用的系統 DNS,都可能另外建立
socket。
所以有 Proxy,不代表整個 App 已經隔離。

03Linux:從 OS 層做到「無路可退」
Linux 的做法比較直接。
我不打算修改主機的 default
route,也不會把實體網卡搬去別的 namespace。
沒有被管理的 App
照常使用原本的網路。
Platform Manager 先在 host network namespace 建立只允許指定 WireGuard
peer 的 UDP socket。
接著把受限的 FD 交給隔離 namespace 裡的 VPN
worker。
那個 namespace 只有 loopback 和 TUN,不提供通往 host 的
veth/NAT 明文出口。
App 送出的 IP 封包先進 TUN,由 GotaTun 加密,再透過原先在 host namespace
建立的 UDP FD 送到 WireGuard peer。
不過,光是 socket 在 host
建立還不夠。
它可以連去哪個 IP/port、FD 由誰持有,以及 Platform
policy 是否真的生效,這些都要確認。
我比較在意的是,App 根本沒有普通的 host internet 出口。
worker 掛掉就先斷網,沒必要替它找備用路線。
我不能接受 VPN
斷線以後,App 自己繞回 ISP 出口。
但 netns 也不是完整的 sandbox。
App
可能繼承了其他程序的 FD,或透過 Unix socket、D-Bus、host IPC 找到旁路。
04Instance 的啟動與故障恢復流程
WireGuard 握手成功,不代表我就可以讓 App 開始上網。
啟動 Instance 時,先把隔離環境建好,而且預設封閉。
worker
起來後,只允許 WireGuard 握手、DNS 和健康探測。
等目前的設定、Platform
policy 和 worker generation 都確認沒問題,再把 App 和 Gateway 打開。
中間任何一步失敗,就維持 blocked。
重建 worker
時一定要換新的 generation,被 Seal 的舊
generation 不能再開。
Manager 換代、Platform epoch
變更,或使用者在這期間按了 Start/Stop,先前發出的命令都不能再生效。
Watchdog 我分成兩層。
Instance 裡面的 Watchdog 發現問題就先把自己的
ingress 關掉,然後回報故障。
外面的 Instance Manager
才負責記錄意圖、回收舊資源和重建。
我不想看到兩邊同時搶著 restart
同一個 Instance。
手動 Stop 和
EmergencyStop 的優先權一定要最高。
假設 Stop
的時候資料庫剛好壞掉,連最新的停止意圖有沒有成功保存都不知道,系統就不能拿舊的
desired=running 自動開回來。
這時我寧願進入
recovery_required,等人確認。
至於原本的 TCP session 能不能在 crash 後接回來,我沒有要硬保證。
讓連線斷掉,比走錯出口好。
連線狀態不能只有 Connected/Disconnected
我不希望 UI 只有 Connected/Disconnected 兩種狀態。
例如我把 A 設成
desired_state=running,但它目前正在
reconnecting,而且
enforcement=blocked。
這三件事應該分開顯示。
我想讓它繼續運作,跟它現在能不能外送,是不同的事情。
啟動、故障封閉與自動恢復:START/ACTIVATE 循序圖
流程會先把 desired=running 寫進 Store,Manager 再保留
generation 和 identity lease,請 Platform 執行
PrepareClosed。
worker 先以
probe_only 啟動。
確認 tunnel、DNS、policy
和當前的權限資訊都一致後,才執行 CommitResume 和
Activate。
05第一次 Provider 要怎麼建立?這是一個自舉問題
Provider 也有個問題。
剛安裝 VPN Manager 的時候,根本還沒有 VPN
Profile,我總得先去 Mullvad 或 AIRVPN 取得帳號、device 和 WireGuard
設定。
那第一個管理請求要走哪裡?
我目前的想法是只允許第一次有條件的直連。
Provider worker
拿到限時、限帳號、限 HTTPS origin、DNS 與流量預算的
BootstrapGrant。
拿到第一份合法 Profile,就由
Controller 要求 Instance Manager 建立並啟動第一條 VPN。
確認 tunnel 已經能處理管理請求後,先把封閉 direct 的意圖寫進
Store,再撤銷原本的 grant 和 socket,最後才標記
bootstrap_consumed=true,並設定 Provider 的全域出口。
這個順序不能亂,尤其不能在直連還活著的時候,就說已經切換完成。
之後所有 Provider API 都走使用者選定的 VPN Instance。
那條 Instance
掛了,就顯示 blocked,不准切回
host,也不能自動換另一條。
真的處理不了,再由使用者手動選新出口,或明確授權一次性的
rebootstrap。
我還希望每次真正送出 Provider HTTP request 前,都先做一次 IP
preflight。
包括 retry、pagination、token refresh,都要確認同一個
route tuple、IP family 和 connector,拿到只供這次 request 使用的
ProviderRequestPermit 才能送出。
目前暫定 preflight
deadline 3 秒、dispatch window 2 秒。
這會比較慢,也會增加 checker
quota,但至少不會拿 UI 幾分鐘前顯示的 IP 當成現在的選路證據。
UI 要把幾件事情分開顯示:選的是哪條 Instance、這次 request
有沒有真的經過受控 tunnel,以及外部 IP 是不是該 Provider 的出口。
例如我選
Mullvad Instance 去呼叫 AIRVPN 的管理 API,這可以完全符合我的設定。
對外
IP 不是 AIRVPN,不代表流量洩漏。
Provider Adapter 要負責哪些事情
供應商整合我想盡量走同一個流程。
Profile 驗證、Instance
建立、出口綁定由共用的控制邏輯處理;Mullvad、AIRVPN 各自的
device、server 和 port-forward API 才交給 Adapter。
新增 Provider
的時候,我不想每個 Adapter 都有權限直接啟停 Instance 或開 host socket。
Provider API 還有一個麻煩:request 送出去以後
timeout,不代表對方沒有執行。
例如 device
其實建立成功,只是回覆沒有收到。
這時候先記成
unknown,再用 operation journal
查詢遠端狀態,不應該直接重送一次。
PROVIDER 首次自舉循序圖
整個自舉要算完成,必須確認新 Instance 能發出管理請求,原本的 direct
授權也確實撤銷,最後才
CommitEgress。
如果切換中的某個結果無法確認,我寧願先停在
blocked,把狀態查清楚。
06我想看清楚每條 VPN 的流量與資源使用
我不希望 VPN Manager 最後只有幾個綠燈告訴我 VPN 已連線。
我想知道哪條
Instance 正在吃流量、Gateway 有多少活躍連線、DNS 延遲有沒有升高,以及
CPU、記憶體和 queue 被哪個程序占用。
Metrics Service 和 Performance Manager 我會分開。
Metrics Service
負責收集統計資料,像 Instance counters、Gateway payload bytes、WireGuard
UDP bytes、DNS 成功與失敗、active flows、CPU 和 RSS。
Performance
Manager 才負責分析吞吐、延遲、資源效率,或執行我明確啟動的
benchmark。
它不能為了測速就自己改 Instance 的狀態。
Metrics 最好不要對資料面產生反向壓力。
Instance 每秒送一次有界
snapshot,Collector 驗序、去重,後面再用 CBOR/Zstd 壓縮與彙總。
如果收集端塞住,丟幾筆樣本並標記
gap 就好,不能讓封包等資料庫。
流量數字也不能亂算。
Gateway payload bytes 和 WireGuard UDP bytes
是不同層的統計,不能加起來當總流量。
counter reset
或資料中斷時,圖表要顯示缺口或未知,不能直接畫成 0。
goodput
更要有接收端確認,不能只拿 sender counter 來算。
流量監控也不需要把所有東西都記下來。
預設收 counters、histograms
和必要的錯誤資料就好。
DNS query name、完整 URL 或封包
payload,我不想全部塞進 Metrics。
留言與討論
正在連線到留言服務…